这篇文章讲了什么
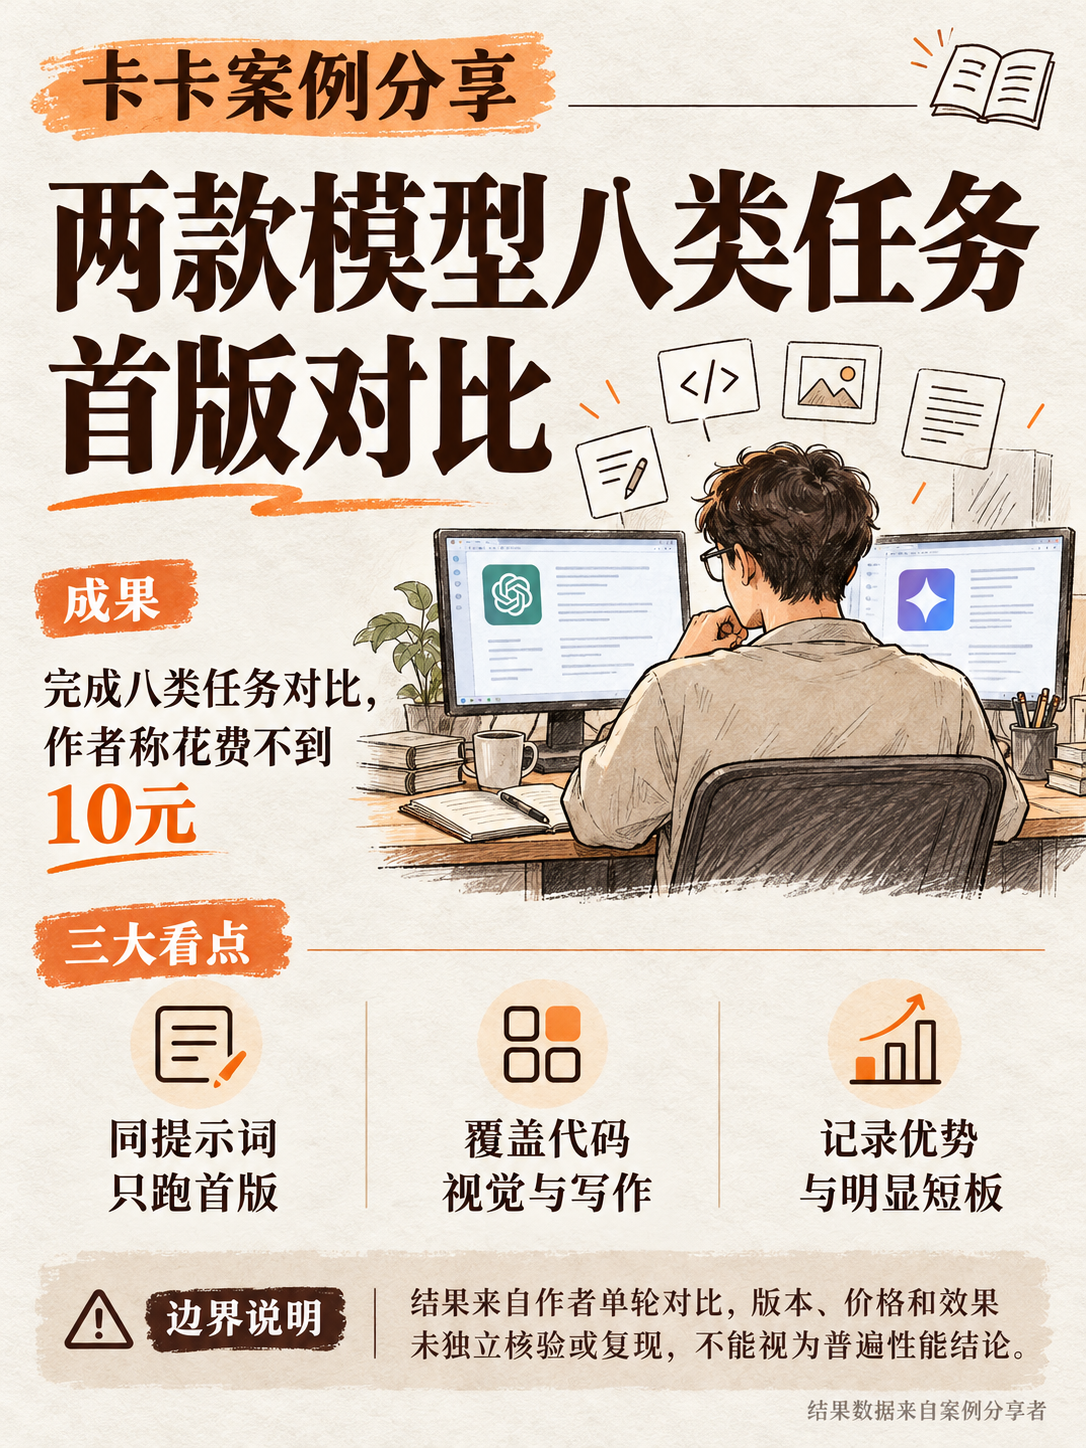
这篇文章围绕模型能否完成真实工作展开。周萝卜用相同提示词比较首版结果,DeepSeek 使用 High 档,Opus 5.5 使用 Medium 档,再结合游戏手感、页面细节、动画表达和中文写作,说明自己的模型分工判断。
作者拿到的成绩
八个案例本轮日常创作任务对比
不到10元作者自述本轮DeepSeek案例测试花费
作者完成八个日常任务案例的对比展示,自述本轮 DeepSeek 案例测试花费不到10元,并展示了视频产物。
想了解这些问题,可以点开看看
- 1
相同提示词、不同推理档位下,首版结果差在哪里?
可看小游戏、落地页和讲解动画的具体比较。
- 2
截图分析和草图还原,作者更喜欢谁?
原帖分别讨论数据分析细致程度、页面表现和交互完整度。
- 3
视频任务最终交出了什么?
可了解作者展示的视频产物,以及他对流程完成度和瑕疵的评价。
- 4
作者准备把哪些工作换给DeepSeek?
作者结合费用、速度和中文写作体验说明自己的取舍。
一图看懂这篇文章