这篇文章讲了什么
这篇文章讲的是知识库怎样真正进入日常工作。浩西AI折腾半年后,发现保存过的结论仍要重新查,于是从研发中的重复问题入手,调整收集入口、检索方式和知识治理,让知识在使用与修正中持续积累。
作者拿到的成绩
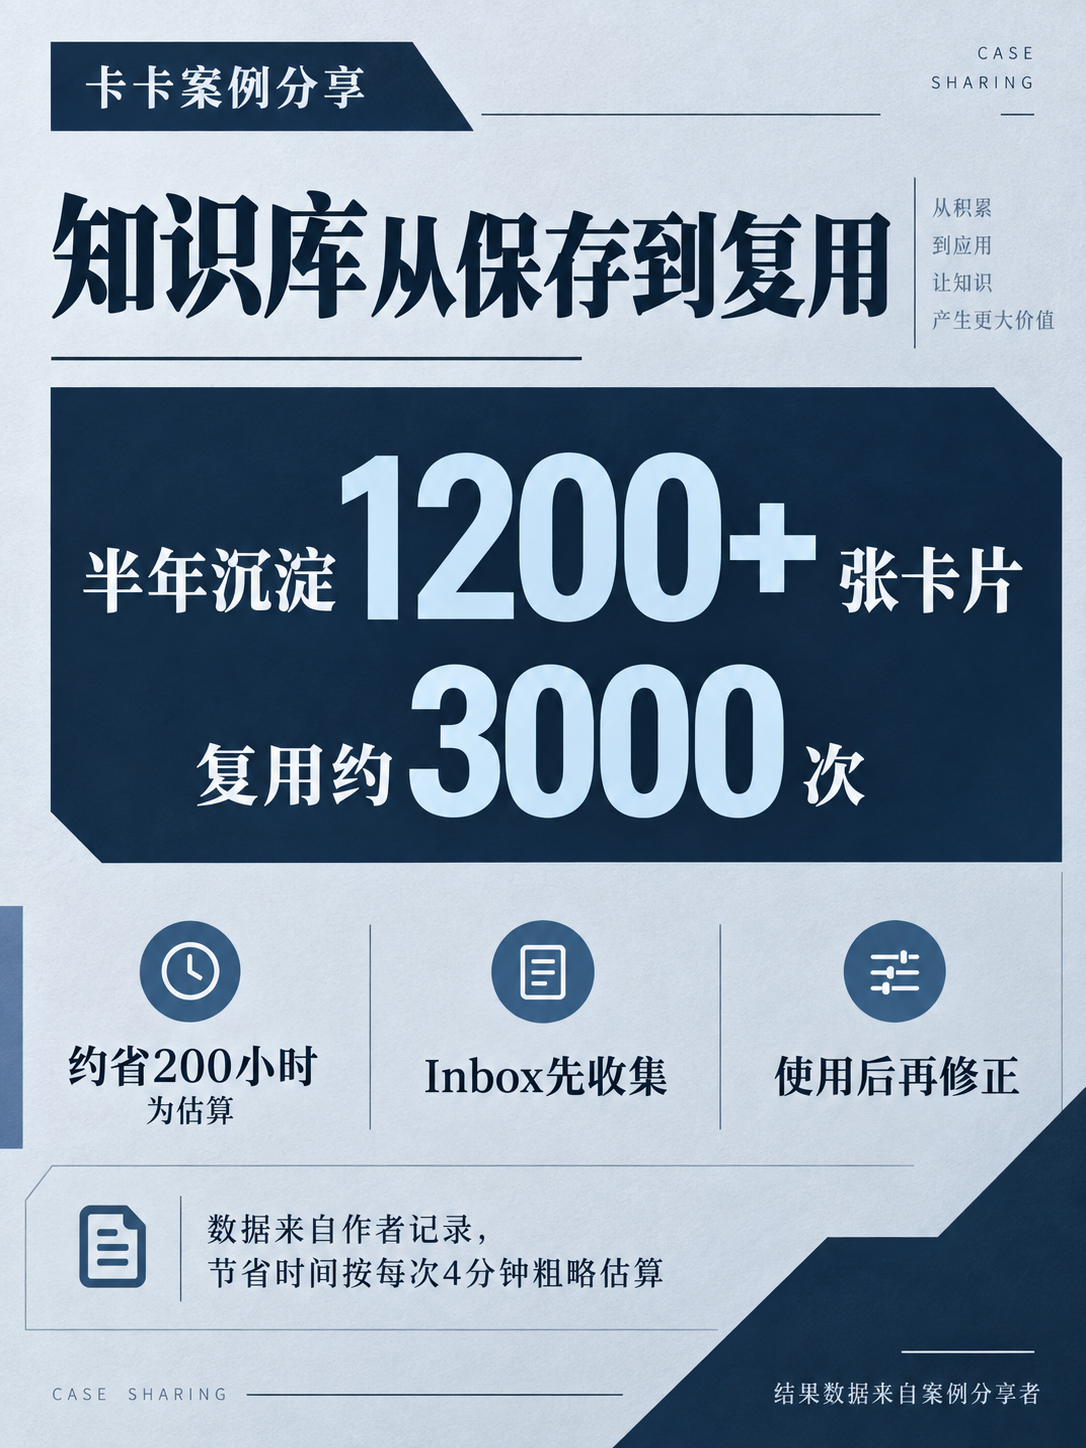
1200+张卡片截至发文时知识库沉淀量
约3000次截至发文时在研发和答疑中被重新检索、复用的次数
约200小时作者按每次重复分析平均4分钟粗略估算节省的重复工作时间
作者跑通了知识复用的最小闭环,截至发文时沉淀1200+张知识卡片,在后续研发和答疑中被重新检索、复用约3000次;按每次重复分析平均4分钟粗略估算,节省约200小时重复工作。
想了解这些问题,可以点开看看
- 1
为什么目录齐全,知识仍然用不起来?
作者结合重复查代码的经历,解释保存与实际使用之间的断点。
- 2
研发分析怎样留下下次能用的知识?
原帖展示接口、字段和上下游关系的记录思路,以及复用前的核对。
- 3
作者为AI助手和业务系统提供了哪些知识库入口?
可了解作者提供的访问入口,以及目前已实现和仍在完善的能力。
- 4
过期、重复或冲突的知识怎样处理?
文章讨论归档、检索优先级和适用条件补充等治理选择。
一图看懂这篇文章